 正版
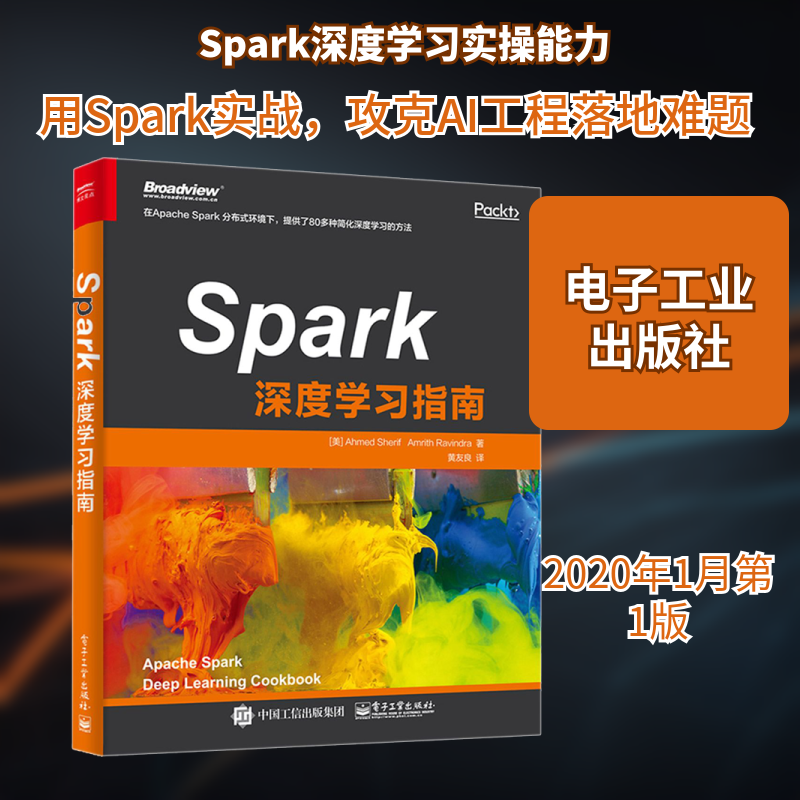
Spark深度学习指南
- 书名
- Spark深度学习指南
- 作者
- (美)艾哈迈德·谢里夫(Ahmed Sherif),(美)阿姆里斯·拉文德拉(Amrith Ravindra) 著 黄友良 译
- 出版社
- 电子工业出版社
- 出版时间
- 2020-01-01
- ISBN
- 9787121378829
- 货号
- 1202003349
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- Spark深度学习指南
- 作者
- (美)艾哈迈德·谢里夫(Ahmed Sherif),(美)阿姆里斯·拉文德拉(Amrith Ravindra) 著 黄友良 译
- 出版社
- 电子工业出版社
- 出版时间
- 2020-01-01
- ISBN
- 9787121378829
- 货号
- 1202003349
- 品相
- 全新
- 分类
- 当代·工业
目录▼
1 为深度学习开发设置Spark 1
介绍 1
下载Ubuntu桌面映像 2
在macOS中使用VMWare Fusion安装和配置Ubuntu 3
在Windows中使用Oracle VirtualBox安装和配置Ubuntu 8
为谷歌云平台安装和配置Ubuntu桌面端 11
在Ubuntu桌面端安装和配置Spark 23
集成Jupyter Notebook与Spark 29
启动和配置Spark集群 33
停止Spark集群 34
2 在Spark中创建神经网络 36
介绍 36
在PySpark中创建数据帧 37
在PySpark数据帧中操作列 41
将PySpark数据帧转换为数组 42
在散点图中将数组可视化 46
设置输入神经网络的权重和偏差 49
规范化神经网络的输入数据 52
验证数组以获得最佳的神经网络性能 55
使用sigmoid设置激活函数 57
创建sigmoid导数 60
计算神经网络中的代价函数 62
根据身高值和体重值预测性别 66
预测分数并进行可视化 69
3 卷积神经网络的难点 72
介绍 72
难点1:导入MNIST图像 73
难点2:可视化MNIST图像 77
难点3:将MNIST图像导出为文件 80
难点4:增加MNIST图像 82
难点5:利用备用资源训练图像 86
难点6:为卷积神经网络优先考虑高级库 88
4 循环神经网络的难点 94
介绍 94
前馈网络简介 95
循环神经网络的顺序工作 103
难点1:梯度消失问题 108
难点2:梯度爆炸问题 111
长短期记忆单元的顺序工作 114
5 用Spark机器学习预测消防部门呼叫 119
介绍 119
下载旧金山消防局呼叫数据集 119
识别逻辑回归模型的目标变量 123
为逻辑回归模型准备特征变量 130
应用逻辑回归模型 137
评估逻辑回归模型的准确度 142
6 在生成网络中使用LSTM 145
介绍 145
下载将用作输入文本的小说/书籍 145
准备和清理数据 151
标记句子 156
训练和保存LSTM模型 158
使用模型生成类似的文本 163
7 使用TF-IDF进行自然语言处理 171
介绍 171
下载治疗机器人会话文本数据集 172
分析治疗机器人会话数据集 176
数据集单词计数可视化 178
计算文本的情感分析 180
从文本中删除停用词 184
训练TF-IDF模型 188
评估TF-IDF模型性能 192
比较模型性能和基线分数 194
8 使用XGBoost进行房地产价值预测 196
下载金斯县房屋销售数据集 196
执行探索性分析和可视化 199
绘制价格与其他特征之间的相关性 210
预测房价 223
9 使用长短期记忆单元预测苹果公司股票市场价格 229
下载苹果公司的股票市场数据 229
探索和可视化苹果公司的股票市场数据 233
准备用于提升模型性能的股票市场数据 238
构建长短期记忆单元模型 246
评估长短期记忆单元模型 249
10 使用深度卷积网络进行人脸识别 252
介绍 252
下载MIT-CBCL数据集并将其加载到内存中 252
绘制并可视化目录中的图像 257
图像预处理 262
模型构建、训练和分析 269
11 使用Word2Vec创建和可视化单词向量 277
介绍 277
获取数据 277
导入必要的库 281
准备数据 284
构建和训练模型 288
进一步可视化 293
进一步分析 300
12 使用Keras创建电影推荐引擎 304
介绍 304
下载MovieLens数据集 305
操作和合并MovieLens数据集 312
探索MovieLens数据集 318
为深度学习流水线准备数据集 322
应用Keras深度学习模型 327
评估推荐引擎的准确度 331
13 使用TensorFlow在Spark中进行图像分类 333
介绍 333
下载梅西和罗纳尔多各30张图像 334
使用深度学习包安装PySpark 339
将图像加载到PySpark数据帧 341
理解迁移学习 344
创建用于图像分类训练的流水线 346
评估模型性能 348
微调模型参数 350
文摘▼
本书开头部分讲了如何按照深度学习的需求来配置Apache Spark,以实现不同类型的神经网络,接下来讲述了在分布式环境中实现深度学习涉及的常见和不那么常见的需求。另外,你还将学到Spark中的深度学习代码,这些代码可以复用到其他类似的问题中,或者稍作改动用于略有不同的问题。将带你一起用Spark对数据进行分流和聚类用TensorFlow、deeplearning4j和 Caffe在Spark中实现和部署深度学习模型,例如CNN、RNN和 LSTM。学完本书的内容,你将能够在Spark上训练和部署有效的深度学习模型。