 正版
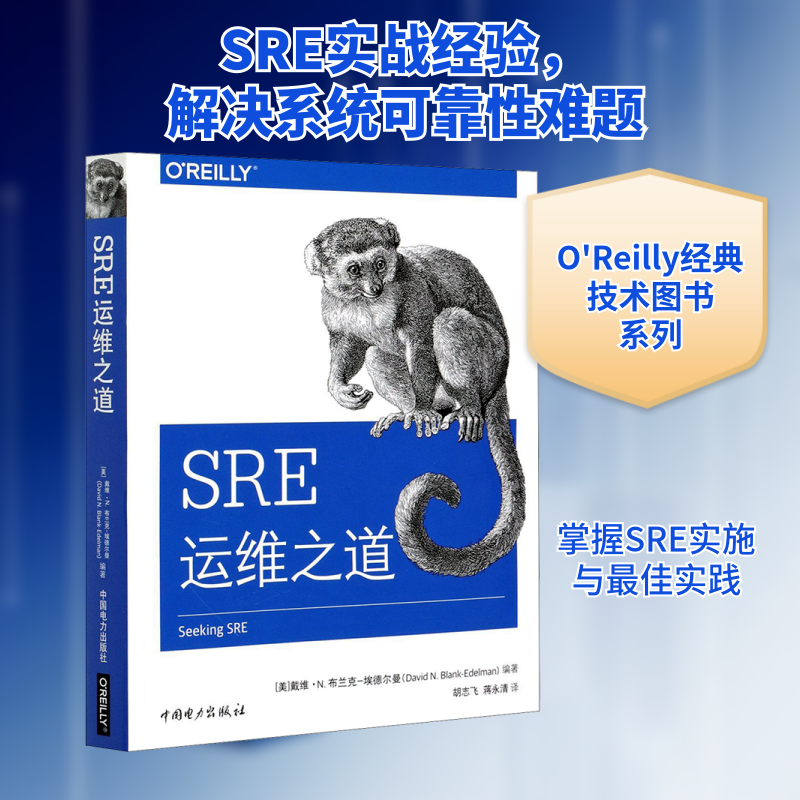
SRE运维之道
- 书名
- SRE运维之道
- 作者
- (美)戴维·N.布兰克-埃德尔曼 编 胡志飞,蒋永清 译
- 出版社
- 中国电力出版社
- 出版时间
- 2021-03-01
- ISBN
- 9787519848453
- 货号
- 1202345722
- 品相
- 全新
- 分类
- 涉及近代·工业
- 书名
- SRE运维之道
- 作者
- (美)戴维·N.布兰克-埃德尔曼 编 胡志飞,蒋永清 译
- 出版社
- 中国电力出版社
- 出版时间
- 2021-03-01
- ISBN
- 9787519848453
- 货号
- 1202345722
- 品相
- 全新
- 分类
- 涉及近代·工业
目录▼
绪论1
第一部分SRE实施
第1章SRE中的上下文与控制7
第2章面试站点可靠性工程师17
面试10117
谁参与17
行业与大学18
偏见18
漏斗18
SRE漏斗19
电话筛查20
现场面试20
带回家的问题22
面试SRE的最终思考24
延伸阅读24
第3章你想建立一个SRE团队吗?25
出于正确的原因选择SRE26
面向数据驱动方法28
对SRE的承诺29
做出关于SRE的决定30
第4章使用事件指标在规模上
提高SRE31
救援到良性循环:你需要测量……31
指标回顾:如果指标无法找到……33
代理指标34
修复债务35
虚拟修复债务:在机器中驱除幽灵36
实时仪表板:SRE的面包和黄油37
学习:终身学习38
延伸阅读38
第5章与第三方合作的艺术39
自建、购买或采用?39
建立重要性40
确定利益相关者40
做出决策41
承认现实42
第三方作为“一等公民”45
当他们倒下时,你也倒下46
像服务一样运行黑匣子48
服务级别指标、服务级别目标和SLA49
行动手册:从预发布到生产51
总结想法58
第6章如何在没有专用SRE团队的情况下应用SRE
原则60
向SRE求救(以及他们如何失败)60
按员工人数计算的规模问题61
嵌入式SRE61
你建造它,你就得运行它62
部署平台62
完成循环:自行运维63
介绍生产工程团队64
一些实施详细信息66
开发人员的工作效率和健康与监控66
使用事后分析解决跨团队可靠性问题68
统一的基础设施和工具与自主和创新69
获得支持者70
小结72
延伸阅读73
第7章无SRE的SRE模式:Spotify案例研究74
蹒跚学步:2006–200775
前奏75
关键收获76
测试版和正式发布:2008–200976
前奏77
将可扩展性和可靠性带到前沿78
关键收获79
成功的诅咒:201080
前奏80
新的所有权模型81
核心服务正规化82
部署时间的抉择83
轮值和警报83
生成内部办公室支持84
解决剩余首要问题84
创建侦探85
关键收获86
宠物和动物,以及敏捷:201187
前奏87
形成不良习惯88
打破那些坏习惯88
关键收获89
无法扩展的系统:201289
前奏89
手工运维碰壁90
关键收获91
介绍小组内嵌运维:2013–201591
前奏91
以信任为基础94
推动模式转变95
关键收获96
自主性与一致性的权衡:2015–201796
前奏97
受益之处98
权衡98
关键收获99
未来:规模化的速度和安全99
第8章大型企业SRE的介绍103
背景103
介绍SRE104
定义当前状态104
识别和教育利益相关者106
展示业务案例108
实施SRE团队109
经验和教训111
实施路线图示例112
总结反思114
延伸阅读114
第9章从系统管理员到SRE115
澄清术语116
服务级别指示器116
SLA117
服务级别目标117
为内部组件建立SLA119
了解外部依赖关系125
非技术解决方案127
跟踪可用性级别128
处理罕见情况133
小结135
第10章为企业中的SRE扫清道路137
琐事,SRE的敌人138
企业中的琐事141
孤岛、队列和工单141
路上的孤岛142
工单驱动的请求队列成本高昂144
立即行动146
从精益开始146
尽可能多地摆脱交接150
将剩余的移交替换为自助服务153
自助服务不仅仅是一个按钮154
自助服务以多种方式帮助SRE155
运维作为服务156
错误预算、限制琐事和其他增强人类能力的工具159
错误预算159
琐事上限160
利用DevOps的现有热情161
统一任务列表并保护容量161
心理安全与人为因素162
加入运动163
第11章SRE模式深受DevOps的热爱164
模式1:Google诞生的自动测试165
模式2:在谷歌启动和移交准备审查167
模式3:创建共享源代码存储库170
小结172
进一步阅读和源材料172
第12章DevOps和SRE:来自社区的声音174
背景174
方法174
结果175
回复175
第13章Facebook的生产工程师191
第二部分SRE前沿领域
第14章起初,有混沌215
系统问题216
复杂性的经济支柱218
开始混沌219
安全和复杂性的权衡220
混沌变大221
形式化221
高级原则222
常见问题223
小结225
第15章可靠性与隐私的交集226
可靠性与隐私的交集概述227
隐私工程的一般景观228
隐私和SRE:常见方法230
减少辛劳230
高效、慎重地解决问题232
关系管理233
早期干预与价值观传播233
细微差别、差异和权衡235
小结236
延伸阅读236
第16章数据库可靠性工程237
数据库可靠性工程师的指导原则237
保护数据238
自助缩放服务238
数据库不特殊239
数据库可靠性工程文化240
可恢复性241
恢复注意事项241
恢复策略的剖析242
构建基块1:检测242
构建基块2:多样化的存储244
构建基块3:各种工具箱245
构建基块4:测试246
倡导恢复可靠性247
持续交付:从开发到生产247
协作249
部署249
迁移和版本控制249
影响分析250
迁移模式250
倡导CD251
为DBRE提供支持252
延伸阅读252
第17章数据耐久性工程253
复制是基础253
备份253
复制254
真实世界的耐久性257
保护261
测试261
保障262
恢复262
验证263
零的力量264
验证范围264
监视器的观察者266
自动化266
漏洞之窗266
运维人员疲劳267
可靠性267
小结268
第18章SRE机器学习概述270
为什么要使用机器学习辅助SRE工作?270
为什么我的公司应该如何参与这项工作?271
AI应用方面的觉醒272
什么是机器学习?273
我们所说的学习是什么意思?274
从国际象棋到围棋:我们可以潜水有多深?276
为什么是现在?我们改变了什么?277
什么是神经网络?278
神经元和神经网络278
应该如何以及何时应用神经网络?280
我们可以使用哪些类型的数据?280
实用机器学习281
神经网络的热门库281
实用机器学习示例282
成功案例296
延伸阅读297
我的GitHub存储库297
推荐书籍297
第三部分SRE最佳实践和技术
第19章使文档更好:将文档集成到工作流程中301
定义质量:好文档是什么样子的?302
SRE文档的功能要求304
将文档集成到工程的工作流中306
谷歌的经验:g3doc和EngPlay307
我们学到的知识310
更好的文档:最佳实践311
为每个文档类型创建模板311
更好>最佳:为质量设定现实标准313
要求将文档作为代码评审的一部分313
大胆地修剪你的文档314
对文档进行表彰和奖励314
传达文档的价值315
延伸阅读317
第20章主动教学和自学319
主动学习320
主动学习示例:不幸之轮321
活动学习示例:事件管理(纸牌游戏)322
活动学习示例:SRE教室326
不能学习的代价327
有效SRE团队的学习氛围328
生产会议328
故障报告329
行动号召:放弃无聊的幻灯片330
第21章服务级别目标的艺术与科学331
为什么要设定目标?331
可用性332
时间计量333
事务334
时间跨度的事务统计334
关于评估SLO335
直方图338
百分位数的不足之处(和直方图的优点)339
思路的不同:自底向上的分析SLO339
延伸阅读340
第22章SRE作为一种成功文化341
SRE是从哪里来的?341
SRE的关键价值343
保持网站运行343
授权团队“做正确的事情”345
将运维视为工程问题346
通过承诺(服务级别)实现业务成功347
SRE的关键启用功能348
监视、指标和KPI348
事件管理和应急响应349
容量规划和需求预测349
性能分析和优化349
预配、更改管理和速度349
SRE执行阶段350
第1阶段:灭火/应急350
第2阶段:守门员350
第3阶段:倡导者/合作伙伴351
第4阶段:催化351
不同阶段的并发症352
关注成功的细节352
延伸阅读353
第23章SRE反模式354
反模式1:站点可靠性运维355
反模式2:人类盯着屏幕356
反模式3:事件响应时一窝蜂357
反模式4:根本原因=人为错误358
反模式5:丢包袱360
反模式6:马戏团表演模式!361
反模式7:警报可靠性工程362
反模式8:雇用他人来遛狗363
反模式9:减速带工程364
反模式10:设计阻塞点365
反模式11:批评太多,鼓励不够366
反模式12:推迟生产环境发布368
反模式13:优先避免故障而不追求快速恢复(MTTF>MTTR)369
反模式14:依赖性地狱371
反模式15:笨拙的治理372
反模式16:考虑不周的SLO373
反模式17:让人恼火的API接口374
反模式18:修复运维团队376
那么,这就足够了吗?377
第24章不变的基础架构和SRE379
可扩展性、可靠性和性能379
故障恢复380
更简单的运维380
更快的启动时间381
已知状态381
自信地完成持续集成/持续部署382
安全性382
多区域操作383
发布的工程学383
构建基本镜像384
部署应用程序385
缺点385
小结386
第25章可编写脚本的负载均衡器387
可编写脚本的负载均衡器:新新人类387
使困难变得简单389
分片感知路由390
利用潜力394
案例研究:休息时间394
服务级别中间件395
作为救援的中间件397
服务级别中间件的API397
案例研究:WAF/Bot缓解397
避免灾难398
获得状态的技巧398
案例研究:结账队列400
展望未来,进一步阅读401
第26章服务网格化:微服务的牧人?403
准备好摆脱全家桶了吗?404
微服务网络的当前状态405
服务网格来救援407
边三轮代理的好处408
最终一致的服务发现409
可观察性和报警机制410
边三轮性能影响411
精简库和上下文传播412
配置管理(控制平面与数据平面)413
实践中的服务网格414
Envoy在Lyft的起源与发展415
Lyft运维的Envoy416
服务网格的未来418
延伸阅读418
第四部分SRE的人性化一面
第27章SRE的心理安全421
成功团队的主要指标421
延伸阅读430
第28章SRE认知工作431
简介431
SRE人员是做什么的?432
我们为什么要关心从业者认知?433
在不确定性和时间压力下做出的关键决策无法重现434
现代复杂系统中的人类表现:主题434
关于围绕事件的SRE认知工作的观察435
每一次事件都可能更糟435
在不确定的情况下做出牺牲性决策436
正常系统的维修437
关于复杂系统的专业知识438
管理协调成本439
SRE是联合认知系统中工作的认知主体439
知识校准问题440
心理模型441
事件触发个人重新校准443
事件是集体重新校准的机会443
这一切意味着什么?444
事件将继续444
事件将导致代价445
事件模式将发生变化446
事件指向特定的校准问题和位置447
接下来会发生什么?447
构建案例库447
专注于使自动化成为SRE中的团队合作者448
解决校准问题449
你能做什么?450
小结451
参考451
第29章胜过倦怠454
定义精神障碍456
多元化对话中缺少对精神障碍的照顾457
纯洁不是业务需求458
光是思想和祈祷还不够459
全栈包容性459
申请职务460
面试过程461
薪酬462
效益463
入职464
工作条件464
工作职责466
培训466
晋升467
离职468
人人为我,我为人人469
精神障碍资源469
第30章反对轮值:一次论战471
轮值的理由472
首先,不造成伤害472
与SRE的相似性472
与SRE的差异473
推动工程师轮值的基本假设474
轮值是急诊医学,而不是病房医学476
反驳意见478
轮值给我们带来的麻烦479
实际解决方案483
培训483
确定优先次序483
提高在职绩效485
我们需要从根本上改变方法486
严格抵制轮值(SAOC)487
尽量避免轮值(WAOC)488
二合一489
小结490
第31章复杂系统的挽歌491
计算机和人类系统无法分离492
消除一致性和级联失败493
始终处于部分故障状态494
优先级倒置的新尝试495
没有人预见到协调的代价495
你的healthcaregov在那里496
延伸阅读497
第32章运维与社会活动之间的交集499
之前、期间、之后500
创建完美计划501
组织原则502
管理危机:在崩溃时做出反应503
书写我们自己的历史:了解到底发生了什么505
长尾效应:将行动转化为革新506
小结509
第33章结语511
作者介绍513
封面介绍513
文摘▼
大大小小的企业和机构已经开始意识到系统和应用程序的可靠性对他们的业务的重要性。他们还发现,以市场需求的速度进行迭代的同时还要保持可靠性有多么困难。站点可靠性工程(SRE)是应对这一挑战的行之有效的方法。SRE是一个广泛而丰富的讨论话题。Google凭借《SiteReliabilityEngineering》一书推动着SRE向前发展。这是一本非常成功的O'Reilly图书,它描述了能让Google成功运维超大规模平台的SRE指导思想和实施细节。受Google早期工作的启发,本书试图发掘SRE领域非常不同的部分。本书用30多章的篇幅带你进入SRE领域正在进行的一些重要对话。聆听工程师和该领域的其他领导人讨论:在各种环境中实现SRE及其指导思想的不同方法。SRE与其他方法(例如DevOps)的关系。最前沿的专业技术很快将在SRE中十分常见。简化实现SRE的最佳实践和技术。重要但很少有人探索的SRE人性的一面。