 正版
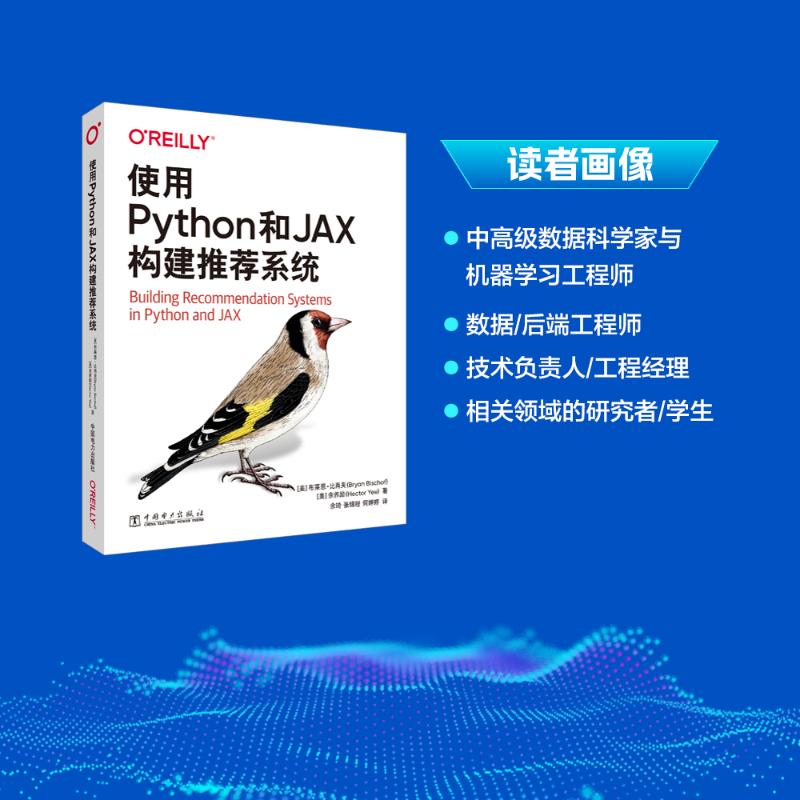
使用PYTHON和JAX构建推荐系统
- 书名
- 使用PYTHON和JAX构建推荐系统
- 作者
- (美)布莱恩·比肖夫(Bryan Bischof),(美)余养励(Hector Yee) 著 余琦,张锦程,何婷婷 译
- 出版社
- 中国电力出版社
- 出版时间
- 2025-06-01
- ISBN
- 9787523900529
- 货号
- 1203696825
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- 使用PYTHON和JAX构建推荐系统
- 作者
- (美)布莱恩·比肖夫(Bryan Bischof),(美)余养励(Hector Yee) 著 余琦,张锦程,何婷婷 译
- 出版社
- 中国电力出版社
- 出版时间
- 2025-06-01
- ISBN
- 9787523900529
- 货号
- 1203696825
- 品相
- 全新
- 分类
- 当代·工业
目录▼
前言 1
第一部分 热身
第1章 概述 11
1.1 推荐系统的核心组件 12
1.1.1 收集器 12
1.1.2 排序器 12
1.1.3 服务器 12
1.2 最简单的推荐器 13
1.2.1 简单推荐器 13
1.2.2 最受欢迎的条目推荐器 14
1.3 JAX 的简要介绍 16
1.3.1 基础类型,初始化和不可变性 16
1.3.2 索引和切片 17
1.3.3 广播 18
1.3.4 随机数 19
1.3.5 即时编译 20
1.4 总结 21
第2章 用户-物品项评分与问题构建 23
2.1 用户-物品项矩阵 23
2.2 用户-用户协同过滤vs 物品项-物品项协同过滤 27
2.3 Netflix 挑战 28
2.4 隐式评分29
2.5 数据收集与用户日志记录 30
2.5.1 日志记录的内容 30
2.5.2 数据收集与事件记录.34
2.5.3 漏斗分析 35
2.6 业务洞察与用户偏好 37
2.7 总结 38
第3章 数学基础 41
3.1 齐夫定律与马太效应在推荐系统中的应用 41
3.2 稀疏性 44
3.3 用户相似性在协同过滤中的应用 46
3.3.1 皮尔逊相关系数 47
3.3.2 基于相似性的评分 48
3.4 探索-利用作为推荐系统 49
3.4.1 - 贪婪算法50
3.4.2 应该设为多少 52
3.5 自然语言处理(NLP)与推荐系统的关系 52
3.5.1 向量搜索 53
3.5.2 最近邻搜索 55
3.6 总结 55
第4章 推荐系统设计 57
4.1 离线vs 在线 57
4.2 收集器 59
4.2.1 离线收集器 59
4.2.2 在线收集器 59
4.3 排序器 60
4.3.1 离线排序器 60
4.3.2 在线排序器 60
4.4 服务器 61
4.4.1 离线服务器 61
4.4.2 在线服务器 61
4.5 总结 62
第5章 综合实践:基于内容的推荐系统 63
5.1 版本控制软件 64
5.2 Python 构建系统 65
5.3 随机物品推荐器 66
5.4 获取STL 数据集图像 69
5.5 卷积神经网络定义 70
5.6 在JAX、Flax 和Optax 中训练模型 71
5.7 输入管道73
5.8 总结 87
第二部分 检索
第6章 数据处理 91
6.1 给系统注入数据 91
6.1.1 PySpark 91
6.1.2 例子:使用PySpark 构建用户相似度 96
6.1.3 DataLoaders 101
6.1.4 数据库快照 104
6.2 用于学习和推理的数据结构 105
6.2.1 向量搜索 106
6.2.2 近似最近邻(ANN) 107
6.2.3 布隆过滤器 108
6.2.4 有趣的分支:将布隆过滤器作为推荐系统 110
6.2.5 特征库 111
6.3 总结 115
第7章 服务模型和架构 117
7.1 推荐系统的架构设计 117
7.1.1 物品到用户的推荐 118
7.1.2 基于查询的推荐 118
7.1.3 基于上下文的推荐 120
7.1.4 基于序列的推荐 121
7.1.5 为什么需要额外特征121
7.2 编码器架构与冷启动 122
7.3 部署 125
7.3.1 模型作为API 125
7.3.2 启动模型服务 126
7.3.3 工作流编排 128
7.4 警报和监控 130
7.4.1 模式和先验 130
7.4.2 集成测试 132
7.4.3 可观察性 133
7.5 生产环境中的评估 134
7.5.1 慢反馈 134
7.5.2 模型指标 135
7.6 持续训练和部署 136
7.6.1 模型漂移 136
7.6.2 部署拓扑 137
7.7 评估飞轮.140
7.7.1 每日热启动 140
7.7.2 Lamada 架构和编排 141
7.7.3 日志记录 142
7.7.4 主动学习 146
7.8 总结 150
第8章 综合实践:数据处理和计数推荐器 151
8.1 技术栈 152
8.2 数据的表现形式 153
8.3 大数据框架 155
8.3.1 集群框架 156
8.3.2 PySpark 示例 157
8.4 GloVE 模型定义 168
8.4.1 在JAX 和Flax 中的GloVE 模型规范 169
8.4.2 使用Optax 进行GloVE 模型训练171
8.5 总结 173
第三部分 排序
第9章 基于特征和基于计数的推荐 177
9.1 双线性因子模型(指标学习) 177
9.2 基于特征的热启动 181
9.3 分段模型和混合模型 183
9.3.1 基于标签的推荐系统184
9.3.2 混合模型 185
9.4 双线性模型的局限性 186
9.5 计算推荐系统数量 188
9.5.1 返回最热门物品的推荐器(MPIR) 188
9.5.2 关联挖掘 189
9.5.3 通过共现计算点互信息 192
9.5.4 基于共现的相似性度量 193
9.5.5 基于相似度的推荐 194
9.6 总结 195
第10章 低秩方法 197
10.1 潜在空间 197
10.2 点积相似度 199
10.3 共现模型 201
10.4 减少推荐系统排名的问题203
10.4.1 利用ALS 优化矩阵分解(MF) 205
10.4.2 矩阵分解的正则化 207
10.4.3 正则化的矩阵因子分解实现 208
10.4.4 WSABIE 233
10.5 降低维度 234
10.5.1 等距嵌入 238
10.5.2 非线性局部可度量化的嵌入 239
10.5.3 中心核对齐241
10.6 亲和力和销售估计器 241
10.7 用于推荐系统评估的倾向性加权 243
10.7.1 倾向 244
10.7.2 辛普森悖论与降低混杂因素的影响 246
10.8 总结 247
第11章 个性化推荐度量指标 249
11.1 环境 250
11.1.1 在线与离线 250
11.1.2 用户vs 物品度量指标 251
11.1.3 A/B 测试 252
11.2 召回率和精确率 253
11.2.1 @k 254
11.2.2 在k 的精准率 255
11.2.3 在k 的召回率 256
11.2.4 r- 精准率 256
11.3 mAP, MMR, NDCG 256
11.3.1 mAP 257
11.3.2 MRR 258
11.3.3 NDCG 258
11.3.4 mAP 与NDCG 的对比 260
11.3.5 相关性系数 260
11.4 用RMSE 考虑亲和度 261
11.5 积分形式的指标:AUC 和cAUC 262
11.5.1 推荐概率与AUC-ROC 262
11.5.2 与其他度量指标比较 263
11.6 BPR 263
11.7 总结 264
第12章 排名训练 265
12.1 排名在推荐系统中的作用是什么 265
12.2 排序学习 266
12.3 训练一个LTR 模型.267
12.3.1 用于排名的分类 267
12.3.2 用于排名的回归 268
12.3.3 用于排名的分类和回归 269
12.4 加权近似排名对(WARP) 269
12.5 k 阶统计量 271
12.6 最佳匹配25(BM25) 272
12.7 多模态检索 275
12.8 总结 276
第13章 综合实践:实验与排序 277
13.1 实验提示 277
13.1.1 保持简单 278
13.1.2 调试打印语句 278
13.1.3 推迟优化 279
13.1.4 记录变更 280
13.1.5 使用特征工程 280
13.1.6 理解模型指标与业务指标的区别 281
13.1.7 快速迭代 281
13.2 Spotify 百万播放列表数据集 282
13.2.1 构建URI 字典 284
13.2.2 构建训练数据 286
13.2.3 读取输入 289
13.2.4 建模问题 292
13.2.5 构建损失函数 295
13.3 练习 300
13.4 总结 301
第四部分 服务
第14章 业务逻辑 305
14.1 硬排序 306
14.2 学习避开项 307
14.3 手工调整权重 308
14.4 库存健康 308
14.5 实现避开项 309
14.6 基于模型的避开项 311
14.7 总结 312
第15章 推荐系统中的偏见 313
15.1 推荐的多样化 314
15.1.1 提高多样性314
15.1.2 应用组合优化 316
15.2 多目标函数 317
15.3 谓词下推 318
15.4 公平性 319
15.5 总结 320
第16章 加速结构 321
16.1 分片 322
16.2 局部敏感哈希(LSH) 322
16.3 k-d 树 325
16.4 分层k-means 328
16.5 更低成本的检索方法 330
16.6 总结 331
第五部分 推荐系统的未来
第17章 序列推荐系统 335
17.1 马尔可夫链 336
17.1.1 二阶马尔可夫链 337
17.1.2 其他马尔可夫模型 338
17.2 RNN 和CNN 架构 339
17.3 注意力架构 341
17.3.1 自注意力序列推荐 343
17.3.2 BERT4Rec 343
17.3.3 时效性采样344
17.3.4 合并静态与序列数据 344
17.4 总结 346
第18章 推荐系统的下一步发展 347
18.1 多模态推荐 348
18.2 基于图的推荐系统 350
18.2.1 神经消息传递 351
18.2.2 应用 353
18.2.3 随机游走 354
18.2.4 元路径与异构性 355
18.3 LLM 的应用 356
18.3.1 LLM 推荐系统 357
18.3.2 LLM 训练 357
18.3.3 推荐系统的指令调优 360
18.3.4 LLM 排名器 360
18.3.5 推荐系统对AI 的帮助 361
18.4 总结 362
文摘▼
实现和设计向用户提供建议的系统是当前最流行且最重要的机器学习应用之一.无论是希望客户在你的在线商店中找到最具吸引力的商品、获取丰富且有趣的视频,还是获取他们需要了解的新闻,推荐系统(RecSys)都能提供解决方案.在这本实用指南中,本书作者阐述了核心概念,并提供示例,帮助你构建适用于任何行业或规模的推荐系统.你将学习构建成功推荐系统所需的数学知识、基本理念,以及具体的实现细节.本书涵盖推荐系统平台的核心组件、MLOps相关工具,以及PySpark、SparkSQL、FastAPI和Weights&Biases中的代码示例和实用建议.你将学习:·构建推荐系统所需的数据.·如何将你的数据和业务问题框定为推荐系统问题.·适用于你的系统的模型评估方法.选择、实现、训练、测试和部署模型的方法.·需要跟踪的关键指标,以确保系统按预期运行.·随着对用户、产品和业务的深入了解,如何不断改进你的系统.