 正版
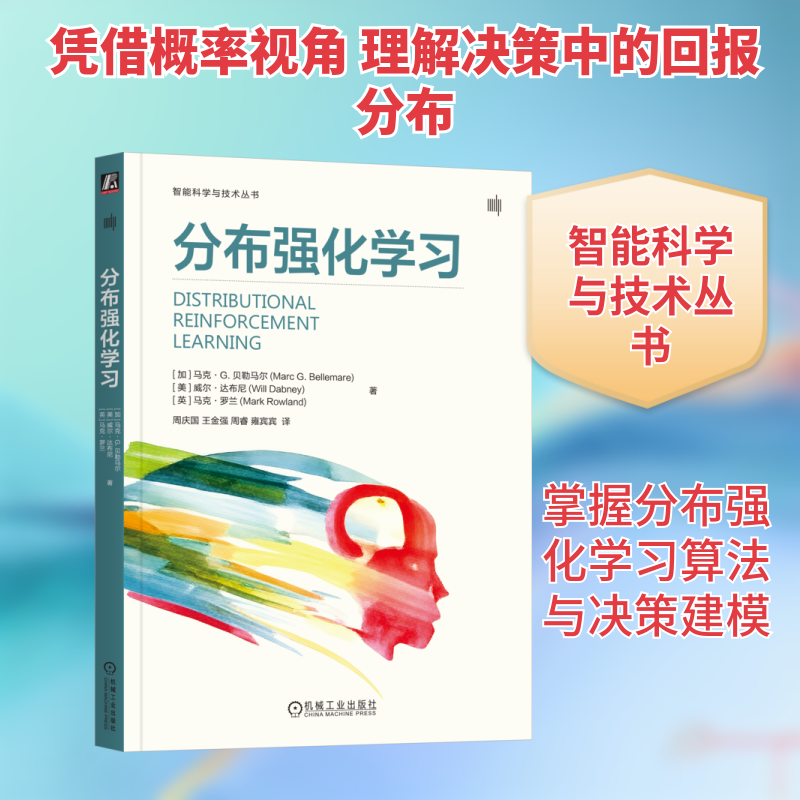
分布强化学习
- 书名
- 分布强化学习
- 作者
- (加)马克·G.贝勒马尔,(美)威尔·达布尼,(英)马克·罗兰 著 周庆国 等 译
- 出版社
- 机械工业出版社
- 出版时间
- 2025-10-01
- ISBN
- 9787111789642
- 货号
- 1203883718
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- 分布强化学习
- 作者
- (加)马克·G.贝勒马尔,(美)威尔·达布尼,(英)马克·罗兰 著 周庆国 等 译
- 出版社
- 机械工业出版社
- 出版时间
- 2025-10-01
- ISBN
- 9787111789642
- 货号
- 1203883718
- 品相
- 全新
- 分类
- 当代·工业
编辑推荐▼
本书是关于分布强化学习的全面指南,为从概率视角思考决策提供了新的数学框架。本书主要介绍分布强化学习的关键概念及应用,对于重要的结果均给出了数学证明,从而说明分布强化学习有能力解释在人机交互环境中产生的许多复杂且有趣的现象。读者将了解一系列算法和数学理论的发展过程,在这些过程中依次对随机回报进行特征描述、计算和估计,最后基于此做出决策。本书就实际问题给出了有效的解决思路,适合机器人学、计算神经科学、心理学、金融(风险管理)等不同领域的技术人员参考。
作者简介▼
马克·G.贝勒马尔(Marc G.Bellemare),Reliant AI 联合创始人、首席科学家,CIFAR AI 首席教授,Mila 核心成员。曾领导 Google Brain 的强化学习研究工作,并曾在 DeepMind 担任研究科学家。此外,他还是麦吉尔大学兼职教授,蒙特利尔大学兼职教授。他拥有阿尔伯塔大学博士学位。
威尔·达布尼(Will Dabney),DeepMind 高级研究科学家,研究兴趣包括强化学习、机器学习和神经科学等。曾在 Amazon Echo 团队担任机器学习科学家。他拥有马萨诸塞大学阿默斯特分校博士学位。
马克·罗兰(Mark Rowland),DeepMind 高级研究科学家,研究兴趣包括强化学习、统计学、概率论、优化和博弈论等。他拥有剑桥大学博士学位。
目录▼
译者序
前言
符号表
第1章 导论1
1.1 为什么是分布强化学习1
1.2 示例:Kuhn扑克2
1.3 分布强化学习有何不同3
1.4 本书的读者对象和结构5
1.5 参考文献备注6
第2章 回报的分布7
2.1 随机变量及其概率分布7
2.2 马尔可夫决策过程8
2.3 弹球模型10
2.4 回报12
2.5 贝尔曼方程16
2.6 随机轨迹的性质17
2.7 随机变量贝尔曼方程19
2.8 从随机变量到概率分布22
2.9 回报分布的替代概念*26
2.10 技术备注26
2.11 参考文献备注28
2.12 练习29
第3章 学习回报分布33
3.1 蒙特卡罗方法33
3.2 增量学习35
3.3 时序差分学习36
3.4 从值到概率38
3.5 投影过程39
3.6 分类时序差分学习42
3.7 学习控制46
3.8 进一步的考虑 47
3.9 技术备注47
3.10 参考文献备注48
3.11 练习49
第4章 算子和度量指标51
4.1 贝尔曼算子51
4.2 收缩映射52
4.3 分布贝尔曼算子54
4.4 回报函数的Wasserstein距离57
4.5 lp概率度量和Cramér距离60
4.6 收缩性的充分条件62
4.7 域问题65
4.8 回报函数的弱收敛性*67
4.9 随机变量贝尔曼算子*68
4.10 技术备注69
4.11 参考文献备注70
4.12 练习71
第5章 分布动态规划76
5.1 计算模型76
5.2 回报-分布函数的表示78
5.3 经验表示79
5.4 正态表示82
5.5 固定大小的经验表示84
5.6 投影步骤86
5.7 分布动态规划89
5.8 扩散引起的误差92
5.9 分布动态规划的收敛性93
5.10 分布近似的质量96
5.11 设计分布动态规划算法98
5.12 技术备注99
5.13 参考文献备注102
5.14 练习103
第6章 增量算法107
6.1 计算与统计估计107
6.2 从算子到增量算法108
6.3 分类时序差分学习109
6.4 分位数时序差分学习111
6.5 理论分析的算法模板114
6.6 合理的步长115
6.7 收敛性分析概述117
6.8 增量算法的收敛性*119
6.9 时序差分学习的收敛性*122
6.10 分类时序差分学习的收敛性*124
6.11 技术备注126
6.12 参考文献备注127
6.13 练习128
第7章 控制131
7.1 风险中性控制131
7.2 价值迭代和Q-学习132
7.3 分布值迭代134
7.4 分布最优算子的动力学135
7.5 存在多个最优策略时的动态分析*139
7.6 风险和风险敏感控制141
7.7 风险敏感控制面临的挑战142
7.8 条件风险价值*144
7.9 技术备注147
7.10 参考文献备注151
7.11 练习152
第8章 统计泛函155
8.1 统计泛函概述155
8.2 矩156
8.3 贝尔曼封闭性159
8.4 统计泛函动态规划161
8.5 与分布动态规划的关系163
8.6 期望分位数动态规划164
8.7 统计泛函的无限集合165
8.8 矩时序差分学习*167
8.9 技术备注168
8.10 参考文献备注169
8.11 练习170
第9章 线性函数近似173
9.1 函数近似和混叠173
9.2 最优线性价值函数近似175
9.3 用于线性价值函数近似的投影贝尔曼算子176
9.4 半梯度时序差分学习179
9.5 分布强化学习的半梯度算法181
9.6 基于带符号分布的算法*184
9.7 带符号算法的收敛性*187
9.8 技术备注189
9.9 参考文献备注191
9.10 练习192
第10章 深度强化学习195
10.1 深度神经网络学习195
10.2 基于深度神经网络的分布强化学习198
10.3 隐式参数化200
10.4 深度强化学习智能体评估202
10.5 预测如何塑造状态表示206
10.6 技术备注207
10.7 参考文献备注207
10.8 练习209
第11章 两个应用和一个结论211
11.1 多智能体强化学习211
11.2 计算神经科学213
11.3 结论217
11.4 参考文献备注218
参考文献220
文摘▼
分布强化学习不仅仅是一种数学方法,而且是一种关于智能体如何进行预测和决策的新视角。它超越了强化学习的传统方法和期望值理论,将重点放在智能体选择所带来的总奖励或回报上,特别是从概率视角探讨这种回报的分布特性。
本书是关于分布强化学习的全面指南,为从概率视角思考决策问题提供了新的数学框架。本书主要介绍分布强化学习的关键概念及应用,对于重要的结果均给出了数学证明,从而说明分布强化学习有能力解释在人机交互环境中产生的许多复杂且有趣的现象。读者将了解一系列算法和数学理论的发展过程,在这些过程中依次对随机回报进行特征描述、计算和估计,最后基于此做出决策。本书就实际问题给出了有效的解决思路,适合机器人学、计算神经科学、心理学、金融(风险管理)等不同领域的技术人员参考。