 正版
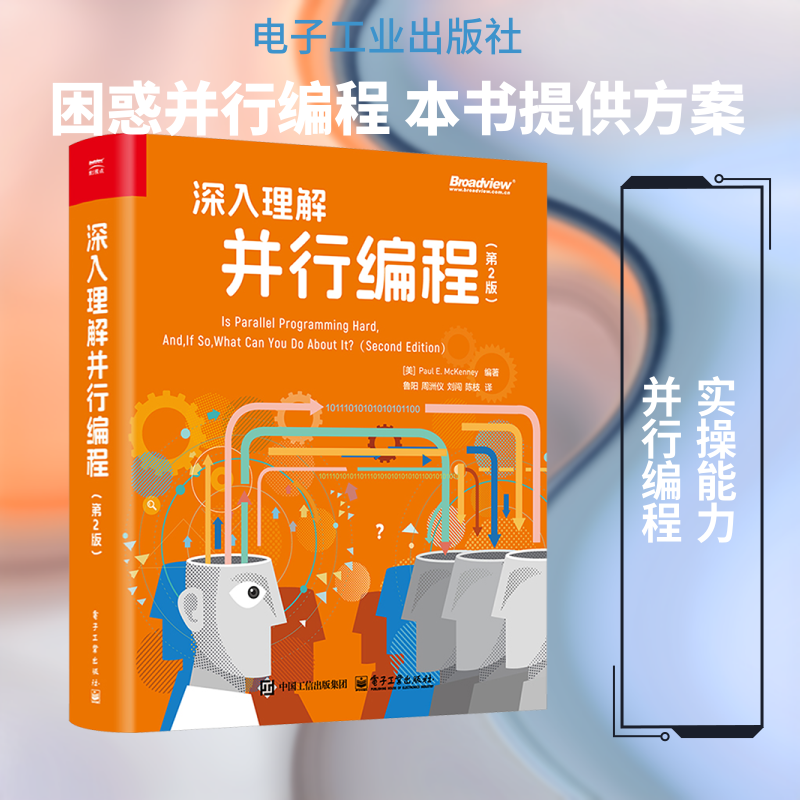
深入理解并行编程(第2版)
- 书名
- 深入理解并行编程(第2版)
- 作者
- (美)保罗·E.麦肯尼(Paul E.McKenney) 编著 鲁阳 等 译
- 出版社
- 电子工业出版社
- 出版时间
- 2026-04-01
- ISBN
- 9787121524073
- 货号
- 1204339142
- 品相
- 全新
- 分类
- 涉及近代·工业
- 书名
- 深入理解并行编程(第2版)
- 作者
- (美)保罗·E.麦肯尼(Paul E.McKenney) 编著 鲁阳 等 译
- 出版社
- 电子工业出版社
- 出版时间
- 2026-04-01
- ISBN
- 9787121524073
- 货号
- 1204339142
- 品相
- 全新
- 分类
- 涉及近代·工业
作者简介▼
保罗·E·麦肯尼(Paul E. McKenney)是世界级并行编程专家,Linux 内核中 RCU 实现和 rcutorture 测试模块的维护者,也是RCU的发明人。对于实时操作系统内核同步机制(例如 Linux 中的实时 RCU)、Linux 和 UNIX 操作系统内核中的 SMP/NUMA 可扩展性和性能、网络性能分析、路由和拥塞控制, 嵌入式实时应用程序有着丰富的经验和研究。 Paul 曾担任IBM Linux 技术中心杰出工程师,发表过 200 多篇论文,拥有 100 多项专利。他的专长包括多线程和多核系统的性能编程、NUMA 架构、开源软件项目。
2009年毕业于成都电子科技大学。加入中兴通讯操作系统团队后,踏上了Linux内核的征程。曾任中兴通讯操作系统部开源总监,推动中兴通讯加入Linux基金会。后曾任职腾讯,曾在波士顿任职于VoltDB,从底层到应用层,着力打造世界最快的内存数据库。
目录▼
第1章 如何使用本书 1
1.1 路线图 2
1.2 小问题 3
1.3 本书之外的选择 4
1.4 示例源代码 5
1.5 这本书属于谁 6
第2章 简介 8
2.1 导致并行编程困难的历史原因 9
2.2 并行编程的目标 10
2.2.1 性能 11
2.2.2 生产率 12
2.2.3 通用性 13
2.3 并行编程的替代方案 15
2.3.1 运行多个串行应用实例 16
2.3.2 利用现有的并行软件 16
2.3.3 性能优化 17
2.4 是什么使并行编程变得复杂 17
2.4.1 任务分片 18
2.4.2 并行访问控制 19
2.4.3 资源分片和复制 20
2.4.4 与硬件交互 20
2.4.5 组合使用 20
2.4.6 语言和环境如何支持这些任务 21
2.5 本章的讨论 21
第3章 硬件和它的特性 22
3.1 概述 22
3.1.1 流水线式的CPU 23
3.1.2 内存引用 25
3.1.3 原子操作 26
3.1.4 内存屏障 27
3.1.5 缓存未命中 27
3.1.6 I/O操作 28
3.2 开销 29
3.2.1 硬件体系结构 29
3.2.2 操作的开销 30
3.2.3 硬件上的优化 33
3.3 硬件免费午餐 34
3.3.1 3D集成 35
3.3.2 新材料和新工艺 36
3.3.3 用光来替换电子 36
3.3.4 专用加速器 37
3.3.5 已有的并行软件 37
3.4 对软件设计的启示 38
第4章 编程的工具 40
4.1 脚本语言 40
4.2 POSIX多进程 42
4.2.1 POSIX进程的创建和销毁 42
4.2.2 POSIX线程的创建和销毁 44
4.2.3 POSIX锁 46
4.2.4 POSIX读写锁 50
4.2.5 原子操作(经典GCC) 53
4.2.6 原子操作(C11) 55
4.2.7 原子操作(现代GCC) 55
4.2.8 每线程变量 55
4.3 POSIX接口的替代者 56
4.3.1 代码组织和初始化 56
4.3.2 线程创建、销毁和控制 56
4.3.3 锁操作 59
4.3.4 访问共享变量 60
4.3.5 原子操作 71
4.3.6 每CPU变量 72
4.4 正确的工具:如何选择 73
第5章 计数 75
5.1 为什么不可小看并发计数 76
5.2 统计计数器 79
5.2.1 设计 79
5.2.2 基于数组的实现 79
5.2.3 基于每线程变量的实现 81
5.2.4 最终一致性的实现 84
5.2.5 本节讨论 86
5.3 近似上限计数器 86
5.3.1 设计 87
5.3.2 简单上限计数器的实现 88
5.3.3 简单上限计数器的讨论 95
5.3.4 近似上限计数器的实现 95
5.3.5 关于近似上限计数器的讨论 96
5.4 精确上限计数器 96
5.4.1 原子上限计数器的实现 96
5.4.2 关于原子上限计数器的讨论 103
5.4.3 信号-窃取(Signal-Theft)上限计数器的设计 103
5.4.4 信号-窃取上限计数器的实现 104
5.4.5 关于信号-窃取上限计数器的讨论 111
5.4.6 精确上限计数器的应用 111
5.5 关于并行计数的讨论 112
5.5.1 并行计数的性能 113
5.5.2 并行计数的专门化 114
5.5.3 从并行计数中学到了什么 115
第6章 对分片和同步的设计 117
6.1 分片练习 117
6.1.1 哲学家就餐问题 118
6.1.2 双端队列 120
6.1.3 关于分片问题示例的讨论 128
6.2 设计准则 128
6.3 同步粒度 131
6.3.1 串行程序 131
6.3.2 代码锁 133
6.3.3 数据锁 134
6.3.4 数据所有权 136
6.3.5 锁粒度和性能 137
6.4 并行快速路径 139
6.4.1 读写锁 140
6.4.2 层次锁 141
6.4.3 资源分配器缓存 142
6.5 分片以外 148
6.5.1 使用工作队列的迷宫问题的并行解法 149
6.5.2 迷宫问题的另一种并行解法 151
6.5.3 性能比较I 154
6.5.4 另一种迷宫问题的串行解法 156
6.5.5 性能比较II 156
6.5.6 未来展望与本节总结 158
6.6 分片、并行化与优化 158
第7章 锁 159
7.1 努力活着 160
7.1.1 死锁 161
7.1.2 活锁与饥饿 169
7.1.3 不公平的锁 171
7.1.4 低效率的锁 172
7.2 锁的类型 172
7.2.1 互斥锁 172
7.2.2 读写锁 173
7.2.3 读写锁之外的锁 174
7.2.4 作用域锁 175
7.3 锁在实现中的问题 178
7.3.1 基于原子交换的互斥锁实现示例 178
7.3.2 互斥锁的其他实现 179
7.4 基于锁的存在性保证 181
7.5 锁:是英雄还是坏蛋 184
7.5.1 应用程序中的锁:英雄 184
7.5.2 并行库中的锁:只是一个工具 184
7.5.3 并行化串行库时的锁:坏蛋 188
7.6 本章总结 190
第8章 数据所有权 191
8.1 多进程 192
8.2 部分数据所有权和pthreads 192
8.3 函数输送 193
8.4 指派线程 194
8.5 私有化 194
8.6 数据所有权的其他用途 195
第9章 延迟处理 196
9.1 运行示例 196
9.2 引用计数 198
9.3 危险指针 203
9.4 顺序锁 210
9.5 读-复制-更新 216
9.5.1 RCU介绍 217
9.5.2 RCU基础机制 225
9.5.3 Linux内核RCU API 234
9.5.4 RCU的使用 246
9.5.5 RCU相关工作 264
9.5.6 RCU练习 268
9.6 如何选择 268
9.6.1 概述 268
9.6.2 细节 270
9.6.3 产品应用 272
9.7 如何处理写操作 274
第10章 数据结构 275
10.1 示例应用 275
10.2 可分片数据结构 276
10.2.1 哈希表设计 276
10.2.2 哈希表的实现 277
10.2.3 哈希表的性能 280
10.3 主读数据结构 283
10.3.1 受RCU保护的哈希表的实现 283
10.3.2 受RCU保护的哈希表的性能分析 285
10.3.3 受RCU保护的哈希表的相关讨论 290
10.4 不可分片的数据结构 292
10.4.1 可变长哈希表的设计 292
10.4.2 可变长哈希表的实现 294
10.4.3 对可变长哈希表的探讨 302
10.4.4 其他类型的可变长哈希表 303
10.5 其他数据结构 306
10.6 微优化 307
10.6.1 专用化 307
10.6.2 位与字节 308
10.6.3 硬件适配 309
10.7 本章总结 311
第11章 验证 312
11.1 简介 313
11.1.1 Bug来自何处 313
11.1.2 验证时所需的心态 314
11.1.3 应该从何时开始验证 316
11.1.4 开源之路 317
11.2 跟踪 319
11.3 断言 320
11.4 静态分析 321
11.5 代码评审 321
11.5.1 审查 322
11.5.2 走查 322
11.5.3 自查 323
11.6 概率及海森堡Bug 325
11.6.1 离散测试统计 326
11.6.2 简单离散测试统计 328
11.6.3 持续测试统计 328
11.6.4 定位海森堡Bug 330
11.7 性能评估 334
11.7.1 性能基准测试 335
11.7.2 剖析 335
11.7.3 差异分析 336
11.7.4 微基准测试 336
11.7.5 隔离 337
11.7.6 检测干扰 338
11.8 本章总结 342
第12章 形式化验证 345
12.1 通用目的的状态空间搜索 345
12.1.1 Promela和Spin 346
12.1.2 如何使用Promela 352
12.1.3 Promela示例:锁 355
12.1.4 Promela示例:QRCU 358
12.1.5 Promela初试牛刀:可抢占RCU和dynticks 368
12.1.6 验证dynticks和可抢占RCU 374
12.2 特定目的的状态空间搜索 402
12.2.1 对litmus测试的剖析 403
12.2.2 litmus测试代表什么 404
12.2.3 运行litmus测试 405
12.2.4 PPCMEM讨论 407
12.3 公理方法 408
12.3.1 公理方法和加锁 410
12.3.2 公理方法和RCU 412
12.4 SAT求解器 415
12.5 无状态模型检查器 417
12.6 本章总结 418
12.7 选择验证方案 419
第13章 合而为一 422
13.1 计数器难题 422
13.1.1 计数更新 422
13.1.2 计数查找 423
13.2 引用计数再改造 423
13.2.1 引用计数分类的实现 425
13.2.2 计数器优化 431
13.3 使用危险指针做辅助 431
13.3.1 可扩展的引用计数 431
13.4 顺序锁的特殊用法 432
13.4.1 关联数据元素 432
13.4.2 升级为写端 433
13.5 使用RCU补救程序 434
13.5.1 RCU和基于每线程变量的统计计数器 434
13.5.2 针对可移除I/O的RCU和计数器 437
13.5.3 数组和长度 438
13.5.4 关联字段 440
13.5.5 对更新友好的遍历 441
13.5.6 再谈可扩展引用计数 441
第14章 高级同步 442
14.1 避免使用锁 442
14.2 非阻塞同步 443
14.2.1 简单NBS 444
14.2.2 对NBS优点的应用 447
14.2.3 NBS相关讨论 449
14.3 并行实时计算 450
14.3.1 什么是实时计算 451
14.3.2 谁需要实时计算 456
14.3.3 谁需要并行实时计算 457
14.3.4 并行实时系统的实现 458
14.3.5 并行实时操作系统的实现 459
14.3.6 实现并行实时应用 472
14.3.7 实时计算和高速计算:如何选择 477
第15章 高级同步:内存序 479
15.1 有序:为什么和怎么做 479
15.1.1 硬件为什么会打乱内存访问顺序 481
15.1.2 如何强制有序 483
15.1.3 基本经验法则 486
15.2 技巧和陷阱 488
15.2.1 具有多个值的变量 488
15.2.2 内存引用重排 491
15.2.3 地址依赖 495
15.2.4 数据依赖 497
15.2.5 控制依赖 498
15.2.6 缓存一致性 500
15.2.7 多拷贝原子性 501
15.3 编译时的困惑 515
15.3.1 内存引用的限制 516
15.3.2 地址依赖和数据依赖的困难 517
15.3.3 控制依赖造成的灾难 521
15.4 高级原语 527
15.4.1 内存分配 527
15.4.2 RCU 528
15.5 硬件相关的内存序 540
15.5.1 Alpha 543
15.5.2 ARMv7-A/R 546
15.5.3 ARMv8 547
15.5.4 Itanium 548
15.5.5 MIPS 549
15.5.6 POWER/PowerPC 550
15.5.7 SPARC TSO 551
15.5.8 x86 552
15.5.9 z Systems 553
15.6 哪里需要对内存排序 554
第16章 易于使用 556
16.1 简单是什么 556
16.2 Rusty Scale API设计 557
16.3 修整Mandelbrot集合 558
第17章 未来的冲突 561
17.1 曾经的CPU技术不代表未来 561
17.1.1 单处理器统治一切 563
17.1.2 多线程狂热 564
17.1.3 更多的是一成不变 564
17.1.4 撞上内存墙 564
17.1.5 惊人的加速器 566
17.2 事务内存 566
17.2.1 外部世界 567
17.2.2 进程修改 571
17.2.3 同步 575
17.2.4 讨论 579
17.3 硬件事务内存 581
17.3.1 HTM与锁相比的优势 582
17.3.2 HTM与锁相比的劣势 583
17.3.3 HTM与增强后的锁机制相比的劣势 590
17.3.4 HTM最适合的场合 593
17.3.5 潜在的搅局者 594
17.3.6 结论 597
17.4 形式化回归测试 598
17.4.1 自动转换 598
17.4.2 环境 599
17.4.3 性能开销 600
17.4.4 定位Bug 602
17.4.5 最简单的脚手架 602
17.4.6 相关的Bug 603
17.4.7 形式化回归工具评分表 604
17.5 并行函数式编程 606
17.6 本章总结 607
第18章 回顾过去,展望未来 608
附录A 重要问题 612
附录B “玩具式”的RCU实现 621
附录C 为什么需要内存屏障 644
附录D 小问题答案 666
文摘▼
本书是共享内存并行编程领域兼具理论深度与工程价值的权威指南,专为操作系统内核、并行数据管理系统及低级底层的底层开发者打造。
本书力图颠覆“并行编程高不可攀”的固有认知,指出其核心挑战在于易落入设计陷阱,或概念框架的缺失。本书将并行编程从“黑艺术”重构为系统化工程学科,通过拆解具体任务、提炼可复用的设计技巧,为开发者提供切实可行的实践方案。书中既深入剖析了现代硬件特性对并行软件性能的影响,又全面覆盖了锁、数据所有权、读-复制-更新(RCU)等同步技术,还详解了开发工具、可扩展性设计策略与验证方法。同时,本书独树一帜地强调人因因素,关注程序员在应对复杂共享内存系统时的理性决策逻辑,助力开发者高效攻克并行编程难题。