 正版
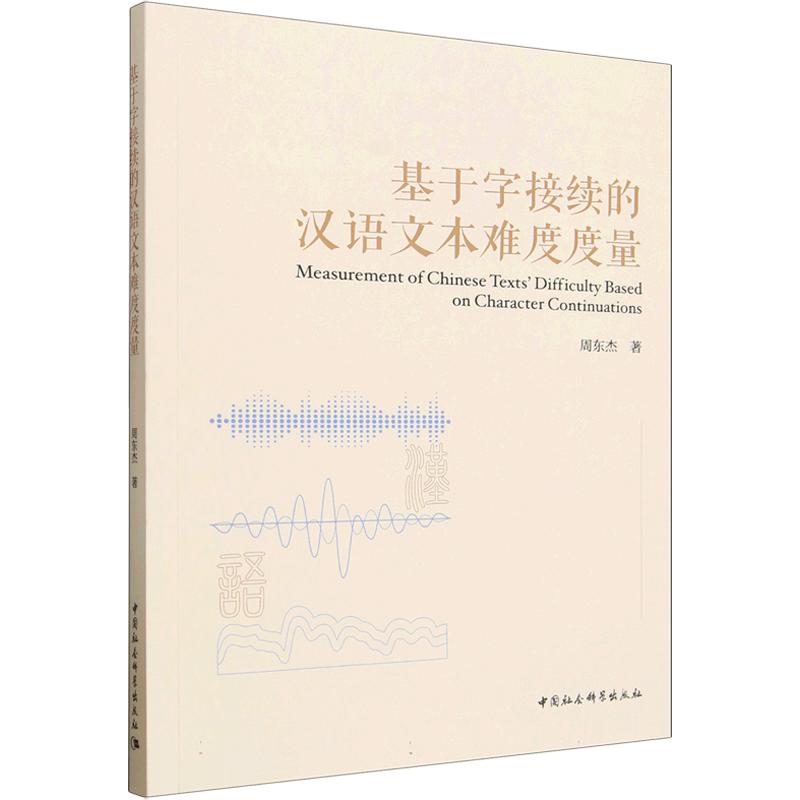
基于字接续的汉语文本难度度量
- 书名
- 基于字接续的汉语文本难度度量
- 作者
- 周东杰 著
- 出版社
- 中国社会科学出版社
- 出版时间
- 2026-05-01
- ISBN
- 9787522769158
- 货号
- 1204483328
- 品相
- 全新
- 分类
- 当代·语言文字
- 书名
- 基于字接续的汉语文本难度度量
- 作者
- 周东杰 著
- 出版社
- 中国社会科学出版社
- 出版时间
- 2026-05-01
- ISBN
- 9787522769158
- 货号
- 1204483328
- 品相
- 全新
- 分类
- 当代·语言文字
作者简介▼
周东杰,女,博士,福建理工大学人文学院教师,硕士生导师,研究领域为计量语言学、文本难度度量、语料库建设、南岛语族研究。主持国家社科基金青年项目1项、福建省社科基地重大项目1项、福建省教育厅信息专项1项、横向项目1项,参与国家社科基金重大项目、国家社科基金重点项目、教育部语合中心青年项目、国家语委项目和省级社科项目等多项科研项目。发表SCI、SSCI、CSCD、CPCI等收录论文近十篇,撰写的咨政报告获国家级、省级等部门采纳6篇。
目录▼
第一章 绪论
第一节 研究背景
一 近年来汉语文本难度度量问题受到广泛关注
二 汉语文本难度度量需要简单有效的手段
三 重视汉语自身特点是破解汉语研究问题的关键
第二节 研究目标和研究意义
一 研究目标
二 研究意义
第三节 研究现状
一 文本难度度量研究现状
二 字接续研究现状
第四节 研究的理论基础
一 语言中的临摹性和时间顺序原则
二 N-Gram
三 文本的静态难度与动态难度
四 语言的稳定态与变化态
第五节 研究的特色与贡献
第六节 本书的研究内容和章节组织架构
一 研究内容
二 章节组织架构
第二章 面向文本难度度量的分级语料库建设
第一节 作文分级语料库建设
一 语料选材
二 语料加工规范
三 语料库建设过程中所使用的技术和软件
四 语料库建设成果:语料的规模与分布分析
五 小结
第二节 教材分级语料库建设
一 语文教材分级语料库建设
二 科学教材分级语料库建设
第三节 语料的使用
一 训练语料与测试语料比例的确定
二 不同用途的语料规模计算
第四节 本章小结
第三章 字接续度量文本难度的理论探讨及可行性论证
第一节 字接续的阐释
一 接续及字接续概念界定
二 字接续的类型分析
三 字接续所具有的特性分析
四 字接续与其他相关概念的关系阐释
五 字接续度量文本难度的切入视角
第二节 字接续度量文本难度在数据层面的可行性论证
一 字接续对文本难度等级的区分效果考察
二 字接续度量文本难度的最佳长度确定
第三节 字接续表征文本难度的语言理据论证
一 字接续在表征文本难度上的作用概括
二 字接续对文本组合难度的表征
三 字接续对文本静态语言单位难度的表征
四 字接续的等级性分析
五 分析所得结论
第四节 本章小结
第四章 基于字的接续能力的文本难度度量
第一节 字的接续能力界定及计算
一 字的接续能力界定
二 字的接续能力计算
第二节 字接续指数资源表的相关特性考察
一 字接续指数资源表与其他字表的关系
二 字接续指数资源表自身所具有的特性
第三节 字接续指数与文本难度等级的关系考察
一 不同年级文本的字接续指数变化分析
二 不同学段(三学段)文本的字接续指数变化分析
三 不同学段(两学段)文本的字接续指数变化分析
四 各年级与各学段文本用字的接续指数差异显著性分析
五 字接续指数随文本难度等级变化的案例分析
第四节 文本难度判定方法及判定结果
一 基于字接续指数的文本难度判定方法
二 文本难度判定效果
第五节 本章小结
第五章 基于有效二字接续提取的文本难度度量
第一节 字接续切分与数据统计
一 字接续切分
二 二字接续基本信息统计
第二节 有效二字接续提取及其资源库建设
一 有效二字接续界定
二 类内有代表性二字接续提取
三 类间有区别性二字接续提取
四 有效二字接续提取及资源库建设结果
第三节 基于有效二字接续资源的文本难度判定
第四节 本章小结
第六章 基于新涌现的稳定使用二字接续提取的文本难度度量
第一节 新涌现的稳定使用二字接续资源库建设
一 各年级新涌现的稳定使用二字接续资源库建设
二 各学段(三学段)新涌现的稳定使用二字接续资源库建设
三 各学段(两学段)新涌现的稳定使用二字接续资源库建设
第二节 文本难度的度量方法
一 i+1文本难度测度方法提出的理论依据
二 i+1文本难度测度方法的工作原理及实现
三 i+1文本难度测度方法中“+1”评价指标设定
四 i+1文本难度测度方法判定文本难度示例
第三节 文本难度度量结果
一 文本的年级难度判定效果
二 文本的学段(三学段)难度判定效果
三 文本的学段(两学段)难度判定效果
四 文本难度度量个案分析
第四节 本章小结
第七章 基于二字接续使用倾向的文本难度度量
第一节 二字接续使用倾向值的计算方法
第二节 二字接续的使用倾向值计算及其资源库建设
一 基于使用度的二字接续使用倾向值计算及其资源库建设
二 基于频率的二字接续使用倾向值计算及其资源库建设
第三节 文本难度度量
一 文本难度度量方法
二 文本的年级难度度量效果
三 文本的学段(三学段)难度度量效果
四 文本的学段(两学段)难度度量效果
第四节 本章小结
第八章 文本难度度量与分析系统的建设与应用
第一节 文本难度度量的资源库及方法整合
一 前文研究的文本难度度量资源库及度量方法汇总
二 文本难度度量模型的整合
三 文本难度度量与分析系统中文本难度判定模型的选择
第二节 文
文摘▼
本书聚焦汉语文本难度度量研究短板,立足汉语自身特点,引入字接续概念,规避分词局限,创新以字组合视角综合测度文本难度。研究首先通过构建大规模小学教材与小学生作文分级语料库,验证字接续度量汉语文本难度的有效性,探讨字接续度量文本难度的最佳长度,发现二字接续度量汉语文本难度综合效果最优。其次依托二字接续研发四种汉语文本难度度量模型,其中新涌现的稳定使用二字接续资源库结合i+1文本难度测度方法的模型表现最佳,测评精度比肩深度学习复杂模型。最后整合本研究开发的资源与算法,搭建汉语文本难度度量与分析系统,实现汉语文本难度自动分级与相关分析。研究突破现有汉语文本难度评价体系局限,开辟全新度量路径,研发的实用系统能为基础教育阶段一线教学中阅读材料的甄选与编纂提供技术支撑。