 正版
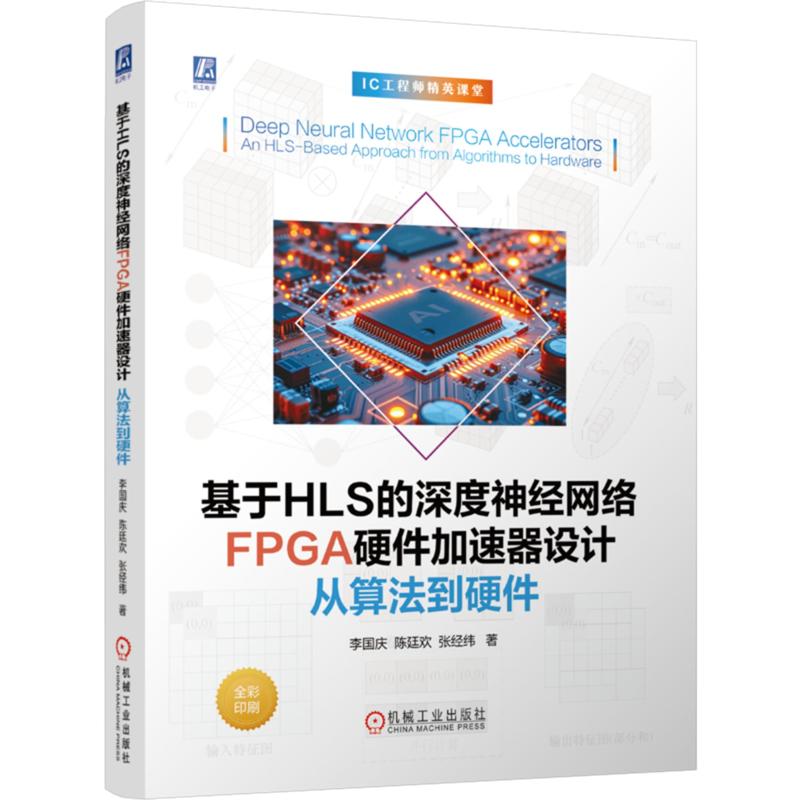
基于HLS的深度神经网络FPGA硬件加速器设计:从算法到硬件
- 书名
- 基于HLS的深度神经网络FPGA硬件加速器设计:从算法到硬件
- 作者
- 李国庆,陈廷欢,张经纬 著
- 出版社
- 机械工业出版社
- 出版时间
- 2026-08-01
- ISBN
- 9787111813736
- 货号
- 1204485754
- 品相
- 全新
- 分类
- 当代·艺术
- 书名
- 基于HLS的深度神经网络FPGA硬件加速器设计:从算法到硬件
- 作者
- 李国庆,陈廷欢,张经纬 著
- 出版社
- 机械工业出版社
- 出版时间
- 2026-08-01
- ISBN
- 9787111813736
- 货号
- 1204485754
- 品相
- 全新
- 分类
- 当代·艺术
编辑推荐▼
在现代边缘计算背景下,通过“算法-硬件协同设计”的方法论,并借助高层次综合(HLS)这一高效工具,我们能够系统化地克服深度神经网络部署的算力与能效瓶颈,最终在FPGA平台上实现性能、功耗与开发效率的最佳平衡。
本书不仅仅是讲解HLS工具的使用,或罗列几种硬件架构,其贯穿始终的灵魂是:传授一种将算法灵感与硬件潜力相结合的系统工程思维,并提供一个经过实践验证的、可执行的框架,引导读者成功打造出属于自己的高效DNN硬件加速器。
本书还具有以下特点:
?系统性:覆盖从 DNN 理论、量化技术、加速器原理到 HLS 工具使用的完整知识链条。
?实战性:核心内容落脚于具体、可操作的加速器设计实例,提供清晰的架构思路、代码片段(或关键设计描述)和优化要点,而非泛泛而谈。
?针对性:重点剖析了两种主流且具代表性的加速器架构模式(复用式 vs. 流水线式),使读者能掌握不同场景下的设计权衡与实现方法。
?工具导向: 以业界广泛应用的 Vivado HLS (Vitis HLS)作为核心工具平台,使读者所学技能可直接应用于工程实践。同时此方法也适用于其它高层次综合工具。
?本书附带电子附件,包含了书中加速器实战的所有代码。
本书适合电子工程、计算机工程、计算机科学等相关专业的本科生、研究生,以及从事AI 芯片设计、FPGA 开发、嵌入式AI 系统开发、边缘计算解决方案设计的工程师和研究人员阅读。
作者简介▼
李国庆 正高级工程师,2022年博士毕业于东南大学,现任国内某大型IT企业首席工程师。从事深度神经网络压缩与硬件加速技术研究,主持中国博士后面上项目、山东省青年基金、国家重点研发计划子课题等多项基金项目。在相关领域发表SCI/EI论文40余篇,包括IEEE TCAD、IEEE TCASI、IEEE TNNLS、Science China Information Sciences、ACM TODAES、ACM TECS等领域顶级期刊和DAC、ICCAD、ASSCC等顶级会议。2022‑2023年,连续两次获得TinyML@ICCAD国际竞赛奖励。2022‑2024年,连续三年获得DAC‑SDC国际竞赛奖励。获山东省人工智能奖自然科学三等奖、山东省自动化学会青年科技奖(提名)、山东省自动化学会自然科学二等奖、山东省自动化学会科技进步二等奖等奖项。
陈廷欢 香港中文大学(深圳)理工学院助理教授、副研究员、博士生导师。入选国家级青年人才计划,国家重点研发计划微纳电子技术重点专项青年首席科学家。近年来在IEEE、ACM等刊物上发表集成电路相关论文80余篇。获得2020、2021年DATE、2024年ISPD、2025年ASP‑DAC会议最佳论文提名奖、2023年EDAthon竞赛世界第二名、山东省人工智能学会自然科学三等奖、山东省自动化学会自然科学二等奖、山东省自动化学会科技进步二等奖等。
张经纬 2025年博士毕业于东南大学,获得电子信息博士学位,现任国内某集成电路设计龙头企业高级工程师。主要从事神经网络推理加速器以及高层次综合设计的研究工作,并取得优异的科研与实践成果。以第一作者在计算机体系结构领域发表CCF A类期刊和会议论文多篇,包括DAC、Science China Information Sciences等。2022年,在电子设计自动化(EDA)领域的顶级会议ICCAD会议举办的机器学习设计竞赛中,获得当年全球第二佳绩。2022年至2024年,在EDA领域和芯片架构领域的顶级会议DAC会议所举办的人工智能加速微系统设计领域赛事中,连续三年获得全球第一,创造了该赛事“三连冠”的记录。
目录▼
前言
学习说明
第1章 深度神经网络基础 1
1.1 卷积 1
1.1.1 标准卷积 1
1.1.2 深度可分离卷积 3
1.2 池化 5
1.2.1 最大/平均池化 6
1.2.2 全局池化 6
1.2.3 随机池化 6
1.2.4 自适应池化 6
1.3 激活 7
1.3.1 Sigmoid函数 7
1.3.2 双曲正切函数(Tanh) 7
1.3.3 线性整流单元(ReLU) 8
1.3.4 Leaky ReLU 9
1.3.5 Swish函数 9
1.3.6 对比总结 10
1.4 全连接层 11
1.4.1 全连接层的基本概念和特点 11
1.4.2 全连接层的作用 11
1.5 批归一化 12
1.5.1 批归一化的计算步骤 12
1.5.2 批归一化的优点和缺点 13
第2章 经典卷积神经网络 14
2.1 VGG 14
2.1.1 VGG特点简介 14
2.1.2 VGG网络结构 15
2.1.3 VGG网络的参数量和计算量 16
2.1.4 VGG网络的优点和缺点 17
2.2 ResNet 17
2.2.1 ResNet特点简介 18
2.2.2 ResNet网络结构 19
2.2.3 ResNet网络的参数量和计算量 19
2.2.4 ResNet网络的优缺点 20
2.3 MobileNetV2 20
2.3.1 MobileNetV2特点简介 21
2.3.2 MobileNetV2网络结构 22
2.3.3 MobileNetV2网络的参数量和计算量 23
2.3.4 MobileNetV2网络的优点和缺点 23
2.4 YOLOV2 24
2.4.1 YOLOV2特点简介 24
2.4.2 YOLOV2训练过程 27
2.4.3 YOLOV2网络的优缺点 28
第3章 神经网络量化 29
3.1 对称量化与非对称量化 29
3.1.1 对称量化 30
3.1.2 非对称量化 34
3.1.3 量化策略对比总结 38
3.2 训练后量化与感知量化 39
3.2.1 训练后量化 39
3.2.2 感知量化 48
3.2.3 感知量化与训练后量化对比总结 53
第4章 神经网络硬件加速理论 54
4.1 脉动阵列 54
4.1.1 脉动阵列的结构 55
4.1.2 数据流 56
4.1.3 脉动阵列的优点 60
4.2 基于卷积空间算法的硬件加速方法 61
4.2.1 循环展开 62
4.2.2 循环分块 67
4.2.3 循环交换 68
4.3 屋顶模型理论 69
第5章 Vivado HLS介绍 71
5.1 HLS概述 71
5.1.1 HLS的功能特点 72
5.1.2 HLS的优势 73
5.1.3 术语说明 73
5.2 数据类型 74
5.2.1 标准C整数类型 74
5.2.2 任意精度类型 74
5.2.3 浮点类型 75
5.3 基本运算 75
5.3.1 算术运算符 75
5.3.2 算术赋值运算符 76
5.3.3 自增与自减运算符 76
5.3.4 条件与关系运算符 76
5.3.5 逻辑与位运算符 76
5.4 接口类型 77
5.5 循环优化 78
5.5.1 变量循环边界 78
5.5.2 循环流水线化 80
5.5.3 循环展开 82
5.5.4 循环并行化 83
5.5.5 循环依赖关系 85
5.6 数组优化 85
5.6.1 HLS中的数组 86
5.6.2 数组分割 86
5.6.3 数组重组 88
5.6.4 数组映射 90
5.6.5 数组与接口绑定 92
5.6.6 小结 93
……
文摘▼
人工智能(AI),特别是深度神经网络(DNN)近年来在计算机视觉、自然语言处理等领域取得了突破性进展,但其庞大的计算需求给传统CPU和GPU架构带来严峻挑战。为满足边缘计算、自动驾驶、智能终端等场景对低延迟、低功耗、高能效的严苛要求,AI硬件加速器已成为产业界与学术界的核心研究方向。本书将高层次综合(HLS)提升为一种核心的协同设计研究工具,为相关领域的研究人员提供了一套标准化、可复现的研究方法论。
本书通过两个详尽的案例,不仅清晰地展示了深度神经网络硬件加速器的设计过程,更从中提炼出两种具有普遍指导意义的硬件架构范式:计算单元复用式架构——为解决资源受限问题提供了系统性的设计原则与优化策略,是研究高能效比、低成本边缘加速器的典型范本;流水线数据流架构——为追求高吞吐量的应用展示了如何通过精细的流水线设计和数据流调度,最大化硬件并行度与计算效率。从算法模型分析出发,通过HLS进行硬件建模与迭代优化,最终以FPGA为验证平台,能够有效降低设计人员进入“AI加速器设计”这一高门槛领域的难度。
本书适合从事AI芯片设计、FPGA开发、嵌入式AI系统开发、边缘计算解决方案设计的工程师和研究人员,以及电子工程、计算机工程、计算机科学等相关专业的本科生、研究生阅读。