 正版
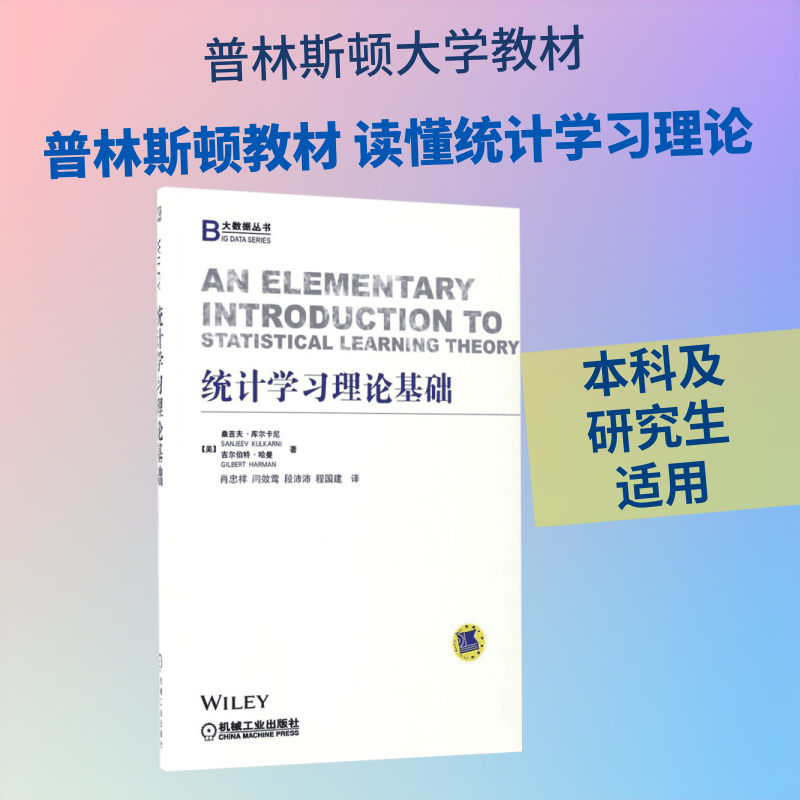
统计学习理论基础
- 书名
- 统计学习理论基础
- 作者
- (美)桑吉夫·库尔卡尼(Sanjeev Kulkarni),(美)吉尔伯特·哈曼(Gilbert Harman) 著;肖忠祥 等 译 著
- 出版社
- 机械工业出版社
- 出版时间
- 2017-03-01
- ISBN
- 9787111555223
- 货号
- 1201475603
- 品相
- 全新
- 分类
- 当代·文化
- 书名
- 统计学习理论基础
- 作者
- (美)桑吉夫·库尔卡尼(Sanjeev Kulkarni),(美)吉尔伯特·哈曼(Gilbert Harman) 著;肖忠祥 等 译 著
- 出版社
- 机械工业出版社
- 出版时间
- 2017-03-01
- ISBN
- 9787111555223
- 货号
- 1201475603
- 品相
- 全新
- 分类
- 当代·文化
作者简介▼
桑吉夫·库尔卡尼(Sanjeev Kulkami)博士是普林斯顿大学电气工程系教授,同时也在运筹学与金融工程系及哲学系担任教职。Kulkami博士在统计模式识别、参数估计、机器学习、信息论等领域发表了大量论文及专著,他是IEEE院士、曾荣获2007年度普林斯顿大学校长杰出教学成果奖。
吉尔伯特·哈曼(Gilbert Harman)博士被评为普林斯顿大学哲学系詹姆斯麦克唐奈杰出教授,同时也是认知科学协会高级研究员,他在伦理学、统计学习理论、推理心理学和逻辑学等研究领域发表了五十余篇论文。
目录▼
译者序
前言
第1章引言:分类、学习、特征及应用
1.1范围
1.2为什么需要机器学习?
1.3一些应用
1.3.1图像识别
1.3.2语音识别
1.3.3医学诊断
1.3.4统计套利
1.4测量、特征和特征向量
1.5概率的需要
1.6监督学习
1.7小结
1.8附录:归纳法
1.9问题
1.10参考文献
第2章概率
2.1一些基本事件的概率
2.2复合事件的概率
2.3条件概率
2.4不放回抽取
2.5一个经典的生日问题
2.6随机变量
2.7期望值
2.8方差
2.9小结
2.10附录:概率诠释
2.11问题
2.12参考文献
第3章概率密度
3.1一个二维实例
3.2在\(0,1\)区间的随机数
3.3密度函数
3.4高维空间中的概率密度
3.5联合密度和条件密度
3.6期望和方差
3.7大数定律
3.8小结
3.9附录:可测性
3.10问题
3.11参考文献
第4章模式识别问题
4.1一个简单例子
4.2决策规则
4.3成功基准
4.4*佳分类器:贝叶斯决策规则
4.5连续特征和密度
4.6小结
4.7附录:不可数概念
4.8问题
4.9参考文献
第5章最优贝叶斯决策规则
5.1贝叶斯定理
5.2贝叶斯决策规则
5.3最优及其评论
5.4一个例子
5.5基于密度函数的贝叶斯定理及决策规则
5.6小结
5.7附录:条件概率的定义
5.8问题
5.9参考文献
第6章从实例中学习
6.1概率分布知识的欠缺
6.2训练数据
6.3对训练数据的假设
6.4蛮力学习方法
6.5维数灾难、归纳偏置以及无免费午餐原理
6.6小结
6.7附录:学习的类型
6.8问题
6.9参考文献
第7章最近邻规则
7.1最近邻规则
7.2最近邻规则的性能
7.3直觉判断与性能证明框架
7.4使用更多邻域
7.5小结
7.6附录:当人们使用最近邻域进行推理时的一些问题
7.6.1谁是单身汉?
7.6.2法律推理
7.6.3道德推理
7.7问题
7.8参考文献
第8章核规则
8.1动机
8.2最近邻规则的变体
8.3核规则
8.4核规则的通用一致性
8.5势函数
8.6更多的通用核
8.7小结
8.8附录:核、相似性和特征
8.9问题
8.10参考文献
第9章神经网络:感知器
9.1多层前馈网络
9.2神经网络用于学习和分类
9.3感知器
9.3.1阈值
9.4感知器学习规则
9.5感知器的表达能力
9.6小结
9.7附录:思想模型
9.8问题
9.9参考文献
第10章多层神经网络
10.1多层网络的表征能力
10.2学习及S形输出
10.3训练误差和权值空间
10.4基于梯度下降的误差最小化
10.5反向传播
10.6反向传播方程的推导
10.6.1单神经元情况下的推导
10.6.2多层网络情况下的推导
10.7小结
10.8附录:梯度下降与反射平衡推理
10.9问题
10.10参考文献
第11章可能近似正确(PAC)学习
11.1决策规则分类
11.2来自一个类中的最优规则
11.3可能近似正确准则
11.4PAC学习
11.5小结
11.6附录:识别不可辨元
11.7问题
11.8参考文献
第12章VC维
12.1近似误差和估计误差
12.2打散
12.3VC维
12.4学习结果
12.5举例
12.6神经网络应用
12.7小结
12.8附录:VC维与波普尔(Popper)维度
12.9问题
12.10参考文献
第13章无限VC维
13.1类层次及修正的PAC准则
13.2失配与复杂性间的平衡
13.3学习结果
13.4归纳偏置与简单性
13.5小结
13.6附录:均匀收敛与泛致性
13.7问题
13.8参考文献
第14章函数估计问题
14.1估计
14.2成功准则
14.3最优估计:回归函数
14.4函数估计中的学习
14.5小结
14.6附录:均值回归
14.7问题
14.8参考文献
第15章学习函数估计
15.1函数估计与回归问题回顾
15.2最近邻规则
15.3核方法
15.4神经网络学习
15.5基于确定函数类的估计
15.6打散、伪维数与学习
15.7结论
15.8附录:估计中的准确度、精度、偏差及方差
15.9问题
15.10参考文献
第16章简明性
16.1科学中的简明性
16.1.1对简明性的明确倡导
16.1.2这个世界简单吗?
16.1.3对简明性的错误诉求
16.1.4对简明性的隐性诉求
16.2排序假设
16.2.1两种简明性排序法
16.3两个实例
16.3.1曲线拟合
16.3.2枚举归纳
16.4简明性即表征简明性
16.4.1要确定表征系统吗?
16.4.2参数越少越简单吗?
16.5简明性的实用理论
16.6简明性和全局不确定性
16.7小结
16.8附录:基础科学和统计学习理论
16.9问题
16.10参考文献
第17章支持向量机
17.1特征向量的映射
17.2间隔最大化
17.3优化与支持向量
17.4实现及其与核方法的关联
17.5优化问题的细节
17.5.1改写分离条件
17.5.2间隔方程
17.5.3用于不可分实例的松弛变量
17.5.4优化问题的重构和求解
17.6小结
17.7附录:计算
17.8问题
17.9参考文献
第18章集成学习
18.1弱学习规则
18.2分类器组合
18.3训练样本的分布
18.4自适应集成学习算法(AdaBoost)
18.5训练数据的性能
18.6泛化性能
18.7小结
18.8附录:集成方法
18.9问题
18.10参考文献
文摘▼
全书共包含18个章节,从概率密度、贝叶斯决策理论引入样本学习的基本概念,进而介绍了近邻域学习、核学习及神经网络学习,在此基础上探讨了PCA学习、VC维概念、函数估计问题等,后重点介绍了非常实用的支持向量机SVM及Boosting方法。各章均包含小结、附录、习题及参考资料,非常适合于大专院校计算机及电气工程类硕博士研究生及高年级学生作为教学参考书。