 正版
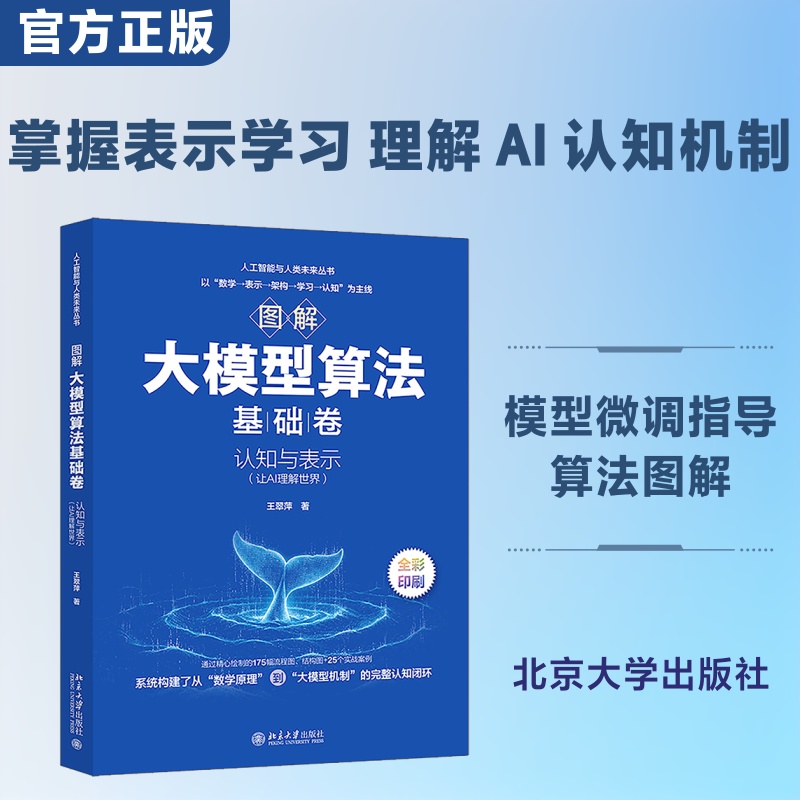
图解大模型算法基础卷:认知与表示(让AI理解世界)
- 书名
- 图解大模型算法基础卷:认知与表示(让AI理解世界)
- 作者
- 王翠萍 著
- 出版社
- 北京大学出版社
- 出版时间
- 2026-12-01
- ISBN
- 9787301378274
- 货号
- 1204588896
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- 图解大模型算法基础卷:认知与表示(让AI理解世界)
- 作者
- 王翠萍 著
- 出版社
- 北京大学出版社
- 出版时间
- 2026-12-01
- ISBN
- 9787301378274
- 货号
- 1204588896
- 品相
- 全新
- 分类
- 当代·工业
作者简介▼
王翠萍 山东大学计算机硕士,浙江大学计算机博士。现在就职于百度智能云,负责大模型应用层算法研发与调优工作,工作期间对百度大模型产品中的对话系统、内容生成、意图理解等核心模块实现了算法优化,提高了产品的效率。基于LLM深入理解用户所需,提升了模型在复杂场景下的推理能力与用户体验,精通Transformer、BERT、GPT等模型架构,擅长LLM微调、RLHF、大规模分布式训练。
目录▼
第1章 大模型训练的数学基础
1.1 概率建模与不确定性
1.1.1 随机变量与常见分布(模型输出视角)
1.1.2 条件概率与贝叶斯定理
1.1.3 期望、方差与不确定性
1.1.4 信息熵(预测不确定性)
1.1.5 实战演练:基于朴素贝叶斯的分类模型
1.2 表示学习:向量与张量
1.2.1 向量空间与嵌入的本质
1.2.2 矩阵变换与神经网络计算
1.2.3 特征值与奇异值分解
1.2.4 张量与高维表示(Transformer基础)
1.2.5 实战演练:基于PCA的数据降维
1.3 训练机制:损失函数与优化
1.3.1 损失函数与训练目标(交叉熵核心)
1.3.2 梯度下降与反向传播
1.3.3 优化算法(SGD/Adam)
1.3.4 优化的收敛性与局部很优问题
1.3.5 实战演练:在分类任务中对比交叉熵与MSE损失函数
1.4 数学如何贯穿大模型训练
1.4.1 概率建模:输入到输出分布
1.4.2 表示学习:Token到向量空间
1.4.3 损失与梯度:模型如何学习
1.4.4 参数更新闭环
第2章 分布对齐与损失函数的本质
2.1 分布度量与对齐
2.1.1 熵、条件熵与不确定性
2.1.2 互信息
2.1.3 KL散度
2.1.4 JS散度
2.1.5 分布对齐在大模型中的作用
2.1.6 实战演练:基于KL/JS散度与模型分布匹配
2.2 损失函数统一视角
2.2.1 交叉熵与KL散度
2.2.2 常见的损失函数
2.2.3 损失函数与优化收敛性
2.2.4 实战演练:在分类任务中对比交叉熵与MSE损失函数
第3章 嵌入与表示空间
3.1 表示学习基础
3.1.1 独热编码到稠密嵌入
3.1.2 向量空间与语义表示
3.1.3 实战演练:词向量语义可视化
3.2 经典的嵌入方法
3.2.1 Word2Vec(上下文预测思想)
3.2.2 GloVe(共现统计与矩阵分解)
3.2.3 FastText(子词建模与泛化能力)
3.2.4 实战演练:语义聚类与OOV处理
3.3 向量空间操作(服务大模型推理)
3.3.1 向量相似度(语义匹配基础)
3.3.2 向量偏移与语义推理(类比能力)
3.3.3 聚类与降维(表示结构理解)
3.3.4 实战演练:相似度与聚类分析
3.4 从词向量到大模型嵌入
3.4.1 静态嵌入与动态嵌入
3.4.2 Token 嵌入在Transformer中的作用
3.4.3 表示学习在大模型中的整体流程
第4章 状态表示学习与序列表示演化
4.1 状态表示学习
4.1.1 状态表示与表示学习基础
4.1.2 状态空间与隐变量(抽象本质)
4.1.3 价值函数与状态编码
4.1.4 表示压缩与抽象层次
4.1.5 实战演练:基于大模型的文本状态表示
4.2 序列表示与上下文建模
4.2.1 表示的动态性:从静态到上下文表示
4.2.2 表示学习与序列建模(LLM核心)
4.2.3 表示演化与下一步预测机制
4.2.4 实战演练:语言模型的序列预测建模
4.3 高层抽象与语义表示
4.3.1 层级表示与抽象建模
4.3.2 语义结构与表示空间
4.3.3 表示泛化与跨任务能力
4.3.4 实战演练:语义表示与任务泛化建模
4.4 从状态表示到大模型表示机制
4.4.1 从状态到Token表示
4.4.2 表示演化与模型行为能力
第5章 Transformer与大模型专属架构
5.1 Transformer架构
5.1.1 Transformer介绍
5.1.2 Transformer的核心组件
5.1.3 多头注意力机制
5.1.4 实战演练:基于Transformer的电影评论情感分类程序
5.2 Transformer作为大模型计算范式
5.2.1 从结构模型到计算范式的重构
5.2.2 基于注意力的全局信息计算机制
5.2.3 Transformer的统一计算范式
5.2.4 实战演练:手写MiniGPT模型
第6章 大模型架构变体
6.1 大模型架构演化(以DeepSeek为例)
6.1.1 DeepSeek中的多头注意力机制
6.1.2 多头潜在注意力机制
6.1.3 动态任务分配
6.1.4 稀疏激活机制
6.1.5 混合专家架构
6.1.6 DeepSeek-R1/R2的训练流程
6.1.7 实战演练:DeepSeek模型的微调
6.2 多模态架构扩展(以豆包为例)
6.2.1 豆包大模型与MoE
6.2.2 UltraMem架构
6.2.3 实战演练:豆包大模型预训练微调
第7章 大模型预训练
7.1 从表示到生成:预训练任务与目标设计
7.2 语言建模基础
7.2.1 自回归与自编码机制对比
7.2.2 掩码预测与序列建模
7.2.3 因果语言模型结构
7.2.4 实战演练:实现n-gram语言模型
7.3 主流预训练模型
7.3.1 BERT架构详解
7.3.2 BART的去噪自编码
7.4 GPT系列模型
7.4.1 GPT模型的架构演化
7.4.2 自回归生成与注意力掩码
7.4.3 预训练与微调流程
7.5 实战演练:基于BERT微调的问答系统
7.5.1 准备环境
7.5.2 数据处理
7.5.3 模型预处理与训练配置
7.5.4 模型评估与指标计算
7.5.5 模型初始化与训练
7.5.6 模型保存与推理测试
第8章 预训练中的自监督学习
8.1 自编码与对比学习
8.1.1 编码-解码结构与表示学习
8.1.2 表示压缩与重构机制
8.1.3 变分自编码器(概率表示思想)
8.1.4 相似性建模与对比学习思想
8.1.5 对比损失(InfoNCE核心)
8.1.6 实战演练:传统自编码器和变分自编码器的对比
8.2 自监督任务设计
8.2.1 伪标签生成与任务构建
8.2.2 掩码建模与去噪学习机制
8.2.3 自监督学习的三种模式
8.2.4 实战演练:多种自监督任务对比
8.3 自监督训练流程与迁移
8.3.1 数据预处理与任务设计
8.3.2 表示结构分析与可视化
8.3.3 自监督模型评估方法
8.3.4 实战演练:自监督训练全流程多维度迁移
第9章 多模态模型
9.1 多模态学习基础
9.1.1 跨模态对齐机制
9.1.2 图像、文本和音频的表示差异
9.1.3 构建多模态嵌入空间
9.1.4 实战演练:实现多模态对齐模型
9.2 典型多模态模型
9.2.1 CLIP:对比式图文对齐
9.2.2 BLIP/BLIP-2:图文生成与问答
9.2.3 Flamingo:视觉+语言对话模型
9.2.4 豆包基于扩散模型的图像生成架构
9.3 实战演练:CLIP模型的增强训练与预评估
9.3.1 功能模块和数据集
9.3.2 创建模型
9.3.3 分词器
9.3.4 损失函数
9.3.5 训练模型与评估模型
9.3.6 文本重写
第10章 表示共享与跨模态语义
10.1 表示共享机制
10.1.1 共享编码器与任务融合
10.1.2 参数共享与知识迁移
10.1.3 跨模态共享空间设计
10.1.4 实战演练:基于Transformer的多任务模型
10.2 跨模态语义理解
10.2.1 模态间的语义对齐
10.2.2 跨模态检索与生成
10.2.3 图文音协同理解
10.2.4 实战演练:基于对比学习的图文跨模态检索
10.3 知识融合与统一建模
10.3.1 多模态知识图谱
10.3.2 语义嵌入的统一表示
10.3.3 通用表示与大模型共性语义
10.4 综合实战:多模态检索增强生成(RAG)
10.4.1 全局配置与模型初始化
10.4.2 链路构建工具
10.4.3 多模态知识融合
10.4.4 多模态检索增强生成实现
第11章 模型从表示走向理解
11.1 表示如何支持理解能力
11.1.1 Token→向量→语义空间
11.1.2 Attention的语义重组作用
11.2 语义结构与抽象表示
11.2.1 层级语义结构
11.2.2 跨任务表示一致性
11.3 多模态统一认知机制
11.3.1 文本/图像/音频语义统一
11.3.2 表示空间的融合能力
11.4 大模型认知表示总结
11.4.1 从表示到理解的统一路径
11.4.2 多模态语义空间整体结构
文摘▼
本书围绕“AI如何理解世界”这一核心问题,系统讲解人工智能算法的认知基础与表示学习原理,构建了从数学理论到大模型预训练的完整知识体系。第一部分“数学与理论基础”梳理概率论、线性代数、优化理论与信息论知识,深入解析熵、KL散度与损失函数的本质,构建AI学习与决策的数学框架;第二部分“表示学习与神经架构”聚焦嵌入与表示空间、状态表示与序列表示演化、Transformer及大模型架构变体,揭示AI如何构建内部语义空间与世界模型;第三部分“大模型预训练算法”解析语言建模、自监督学习、多模态模型与跨模态语义共享机制,深入讲解GPT、BERT、DeepSeek等模型的架构与训练流程,构建统一表示与多模态融合的技术体系。全书以“图解+推导+实战”为特色,强调理论逻辑与工程实践的统一,既能帮助读者夯实数学基础,又能系统掌握表示学习与大模型预训练的核心机制,适合人工智能领域的研究人员与工程开发人员学习进阶。